使用 AI 工具
点击左侧 AI 工具。当前有三项工具:AI 生图、音视频转写、文字配音。点击左上角标题或输入框底部的工具名都可以切换,下次进入会停在上次用的工具。右侧是历史记录,点右上角的侧栏按钮可以展开或收起。
这三项工具都可以直接使用,不需要连接 AI 助手。
先分清:哪些在本机运行,哪些走云端
| 工具 | 本机(离线可用) | 云端(需要 Key) |
|---|---|---|
| AI 生图 | 无 | 生图接口(OpenAI 兼容)或 Google Gemini |
| 音视频转写 | Qwen3-ASR 本地模型、苹果系统自带识别 | Gemini 3.5 云端(原始词级) |
| 文字配音 | VoxCPM2(中文、可克隆)、Kokoro(英文预置音色) | OpenAI 兼容 TTS、ElevenLabs、Deepgram、Google Gemini |
- 本地模型第一次使用需要下载,之后完全在 Mac 上运行,素材不离开本机。下载和卸载在设置 → AI 与模型 → 本地模型统一管理。
- 云端服务需要你自己的 Key,在设置 → AI 与模型 → 云端服务填写。一个 Google Gemini Key 就能用于转写、生图、配音和背景音乐;生图和音乐不在 Gemini 免费额度内,需要先在 Google AI Studio 开通付费。配置方法见设置总览与 API Key。
0.9 起,AI 工具里的“音轨分离”“AI 音乐”和转写的“AI 纠错”已移除。背景音乐可以让你的 AI 助手用 Gemini 生成,字幕纠错交给 AI 助手完成,见交给 AI:模板视频、字幕与文案。
AI 生图
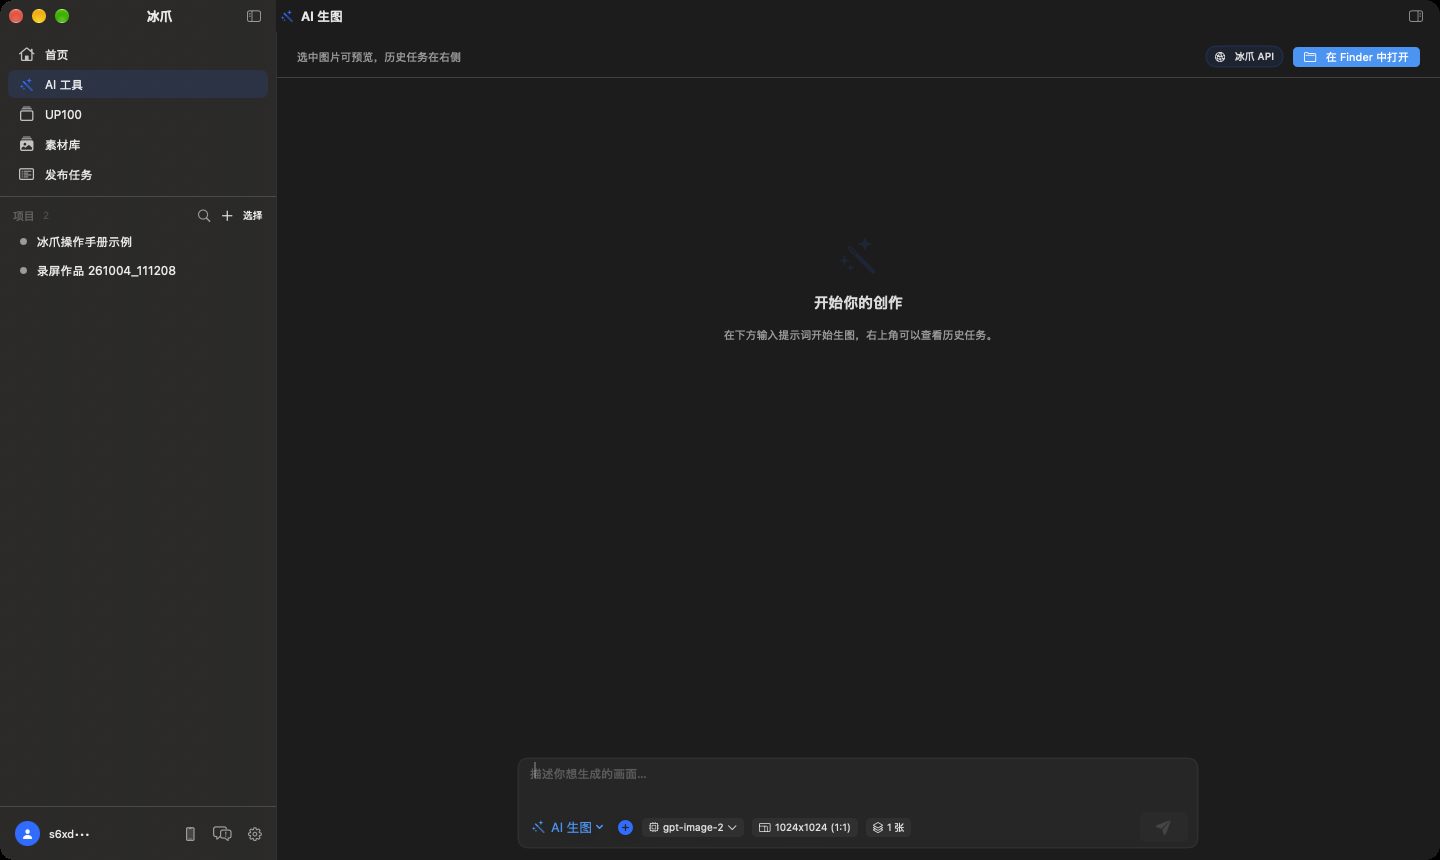
- 切换到 AI 生图。
- 在底部输入想要的画面,例如“桌面上一台银色笔记本电脑,柔和侧光,右上角留出标题空间”。
- 选择模型、尺寸和张数。
- 需要参考图时,点击输入框左侧的 +,或直接拖入、粘贴图片。
- 点击发送,等待图片出现在上方图库。
- 点击图片查看大图。可以直接拖到 Finder、项目或其它 App,也可以点右上角在 Finder 中打开。
用哪条线路生图: 填了“生图接口”就优先用它;没填时,如果配置了 Gemini Key,自动用 Gemini 生图。两者都没配置时,生成按钮会提示先去设置。
历史里的提示词可以一键回填,图库里的图片也可以拖回输入框当参考图。
音视频转写
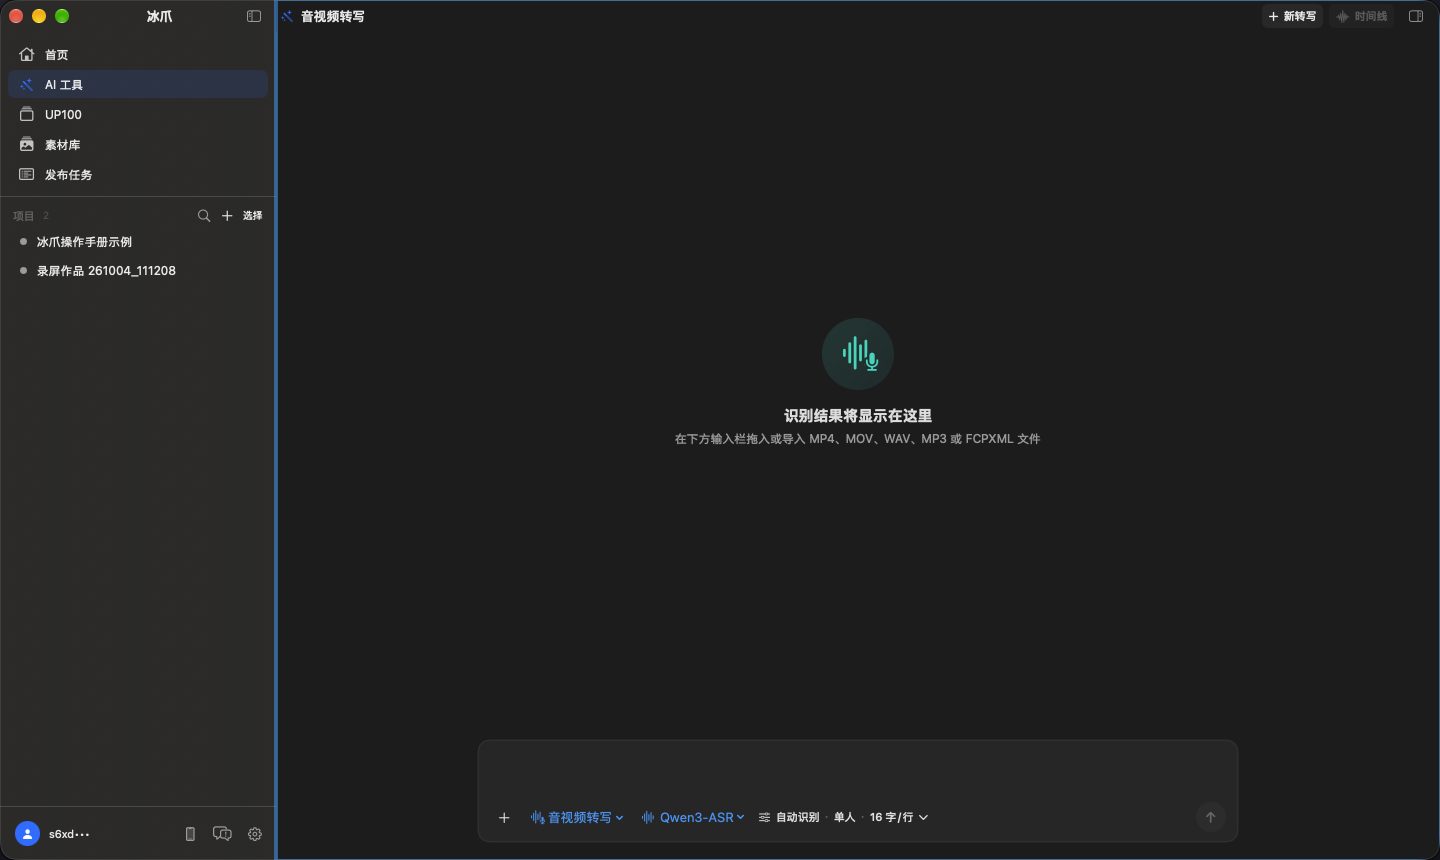
- 切换到音视频转写。正在看旧结果时,先点右上角新转写。
- 点击输入框的 + 选择文件,或直接拖入 MP4、MOV、WAV、MP3 或 FCPXML。
- 在底部选择引擎:
- Qwen3 本地(离线):默认选项,准确度高,第一次需下载模型;
- 苹果系统自带:不用下载,速度快,适合简单内容;
- Gemini 3.5 云端:需要 Gemini Key,音频会上传到 Google 处理。
- 设置语言(默认自动识别)、单人或多人、每行字数。
- 点击发送开始转写。
- 点击字幕跳到对应位置播放,校对人名、数字和专有名词。
- 点击顶部导出,选择 SRT、VTT、TXT 或 FCPXML。
结果有分行、分段、全文三种视图:分行适合逐条改字幕,分段适合读口述内容,全文适合整理文字稿。顶部时间线可以展开波形和字幕轨。转写历史不限条数,不需要时在右侧逐条删除。
精修方法见精修转写与剪后字幕。
文字配音
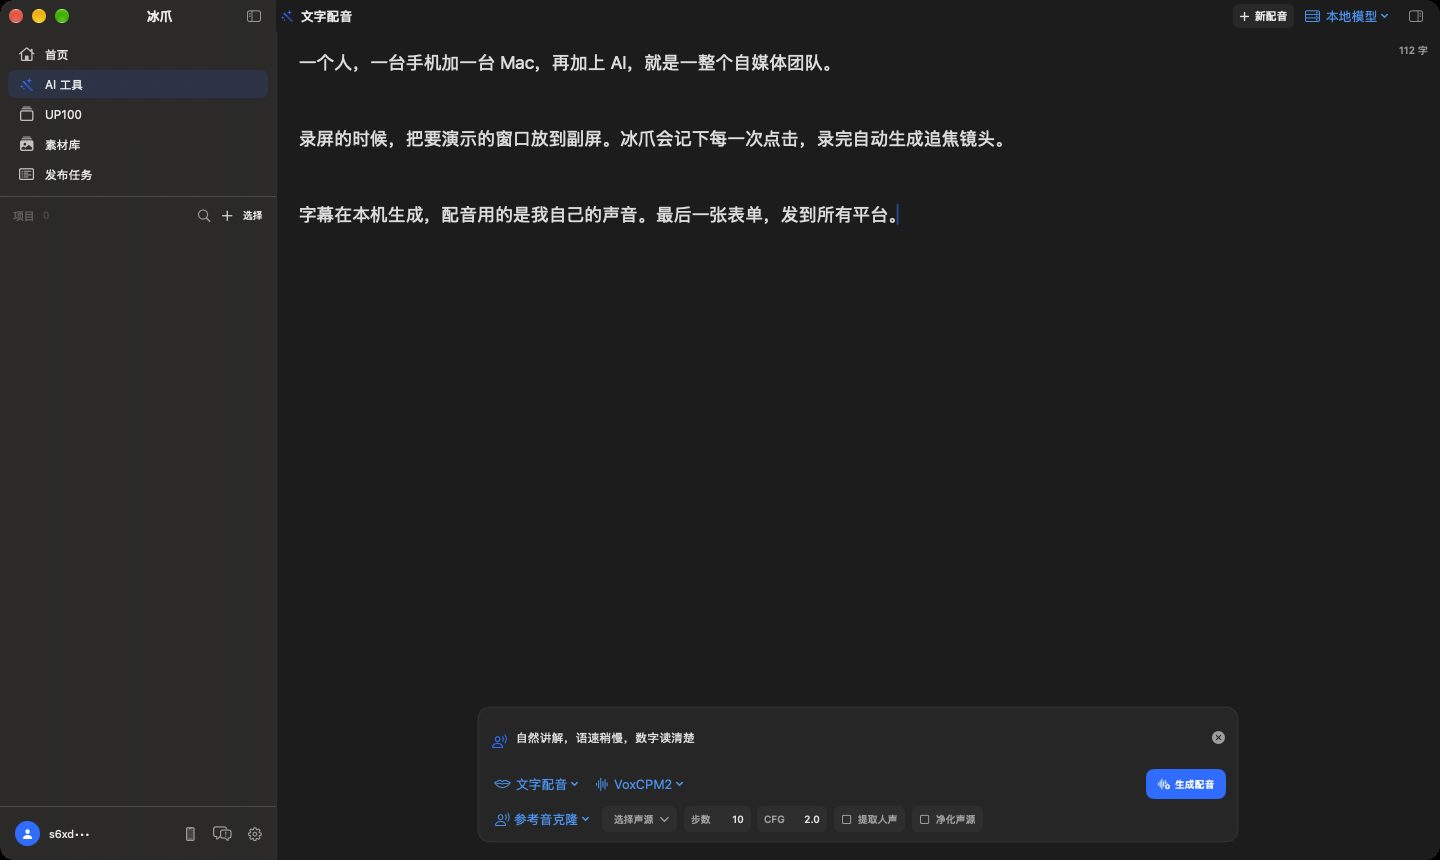
- 切换到文字配音,点击右上角新配音。
- 在上方输入要念的完整稿件。
- 在底部输入框描述音色、情绪和语速,例如“自然讲解,语速稍慢,数字读清楚”。
- 在右上角选择提供方:本地模型、OpenAI 兼容 TTS、ElevenLabs、Deepgram 或 Google Gemini。
- 选择模型和音色,点击生成配音。
- 在右侧历史里试听。音频可以直接拖到 Finder、剪辑软件或其它 App。
本地配音:VoxCPM2 与 Kokoro
- VoxCPM2:中文首选,48kHz。三种模式:文字造音色(用一句话描述想要的声音)、参考音克隆(用一段参考音克隆音色)、高保真克隆(参考音加文字稿)。底部“步数”默认 10、“CFG”默认 2.0,一般不需要改。
- Kokoro:体积很小,50 多种预设音色、10 种语言,适合英文旁白,不支持克隆。
用自己的声音克隆
- 选择 VoxCPM2 和“参考音克隆”,点击选择声源打开声源库。
- 导入一段参考音,或现场录一段(15~30 秒)。
- 试听并保存,选它作为本次声源。
- 输入稿件并生成,重点听停顿、发音和音色。
参考音最好是单人、清晰、背景安静。需要时可以勾选提取人声或净化声源,两项默认关闭。右侧历史里的配音也可以存进声源库再用。
云端配音
| 提供方 | 说明 |
|---|---|
| Google Gemini | 用 Gemini Key,可选 30 种音色(如 Kore、Puck) |
| ElevenLabs | 需要 ElevenLabs Key,可以直接选你账号里的音色 |
| Deepgram | 需要 Deepgram Key,模型名同时决定声音 |
| OpenAI 兼容 TTS | 填服务地址(可以是局域网内自己架的服务),模型和音色按服务支持填写 |
服务地址和 Key 在设置里配置;模型和音色在配音页底部按每次任务选择。
下载模型与处理失败
本地模型没下载时,工具底部会直接显示“未下载 / 下载”,下载中依次显示连接、百分比和速度,失败可以原地重试。
| 情况 | 怎么处理 |
|---|---|
| 生成按钮不能点 | 检查是否输入了内容或选了文件、模型是否下载完成、云端服务是否配置。 |
| 模型下载失败 | 原地重试,检查网络和磁盘空间。 |
| 找不到导入按钮 | 正在看旧的转写结果,先点“新转写”。 |
| 配音读错名字或停顿不对 | 修改稿件或底部要求,重新生成。 |
| 提示“今天的额度用完了” | Gemini 免费额度当天已用完,第二天再试,或在 Google AI Studio 开通付费。 |
| 提示需要开通付费 | Gemini 生图和音乐不在免费额度内,到 Google AI Studio 开通付费。 |
| 其它云端错误 | 看错误文字,核对 Key 和网络;先确认原任务状态,避免重复提交。 |